HTTP认知溯源
HTTP方法本质上就是一个普通的 ASCII 编码字符串,我们可以自定义HTTP方法。从这一点看每个http方法没有什么区别。但是,在应用层,考虑到缓存与网络效能、容错与重试机制、安全隔离与攻击防御等,浏览器、路由器、防火墙、CDN节点、NGINX等应用对各方法做了区别对待。
HTTP方法是在安全和幂等的理念下设计的,语义化的命名有助于互联网生态的协作,在缓存、爬虫、搜索、CDN分发、前后端数据交互等方面能更低成本协作。而REST则是一种设计API的理念,即使用 URI 来标识资源,使用标准的 HTTP 方法 来表示操作。RESTful则是符合这种理念的API。
即使写程序很多年的老鸟,能真正说清楚道明白HTTP方法的也不多,多数都只会使用而不知道所以然。每个人都知道使用GET、POST方法,使用也很熟练,但是底层设计思想并不一定了解。这里,来认真梳理一下HTTP方法背后设计的逻辑。
一. HTTP方法常见10种
HTTP 标准里常见的10 个:
| 方法 | 主要作用 |
|---|---|
| GET | 获取资源 |
| POST | 提交数据 / 创建资源 |
| PUT | 完整替换资源 |
| PATCH | 部分修改资源 |
| DELETE | 删除资源 |
| HEAD | 获取响应头,不返回正文 |
| OPTIONS | 查询服务器支持哪些方法/能力 |
| CONNECT | 建立隧道 |
| TRACE | 请求回显,用于诊断 |
| QUERY | 用于查询搜索(2026年RFC10008新增) |
(实际上HTTP方法数量多达几十种,这里只是列举常见的方法,详见文末)
二.HTTP方法两个核心设计理念:安全(Safe) 与 幂等(Idempotent)
Safe
Read-only by definition
Request methods are considered “safe” if their defined semantics are essentially read-only; i.e., the client does not request, and does not expect, any state change on the origin server as a result of applying a safe method to a target resource. Likewise, reasonable use of a safe method is not expected to cause any harm, loss of property, or unusual burden on the origin server.
The purpose of distinguishing between safe and unsafe methods is to allow automated retrieval processes (spiders) and cache performance optimization (pre-fetching) to work without fear of causing harm. In addition, it allows a user agent to apply appropriate constraints on the automated use of unsafe methods when processing potentially untrusted content.
Idempotent
Same effect when repeated
A request method is considered “idempotent” if the intended effect on the server of multiple identical requests with that method is the same as the effect for a single such request.
Idempotent methods are distinguished because the request can be repeated automatically if a communication failure occurs before the client is able to read the server’s response. For example, if a client sends a PUT request and the underlying connection is closed before any response is received, then the client can establish a new connection and retry the idempotent request. It knows that repeating the request will have the same intended effect, even if the original request succeeded, though the response might differ.
注意:以上的标准是2014年颁布的RFC 7231,QUETY标准出自2026颁布的RFC 10008
- 安全(Safe):
指调用该方法不会修改服务器上的数据(只读操作),直观理解就是不管调用多少次,数据库里的数据都不会被新增、修改或删除。
Safe 方法的语义本质上是只读的,客户端不请求、也不期望服务器因为这个请求而发生状态变化,Safe ≠ Security,更贴切的中文可以理解成无副作用请求,是安全方法。 - 幂等(Idempotent):
指使用相同的参数执行一次与执行多次,对服务器产生的最终状态/结果是完全相同的。直观理解:f(x) = f(f(x))。比如把某人的余额直接“设置为 100 元”,执行 1 次还是 10 次,余额都是 100 元(幂等);但如果是“把余额加上 100 元”,执行 1 次和 10 次结果截然不同(非幂等)。
“幂等”最重要的实际价值:允许安全重试,这是 RFC 定义幂等性的真正工程意义。
| HTTP 方法 | 安全性 (Safe) | 幂等性 (Idempotent) |
| GET | 是 | 是 |
| HEAD | 是 | 是 |
| OPTIONS | 是 | 是 |
| QUERY | 是 | 是 |
| TRACE | 是 | 是 |
| PUT | 否 | 是 |
| DELETE | 否 | 是 |
| POST | 否 | 否 |
| PATCH | 否 | 否*(⚠️ 不一定) |
可以看出,DELETE是不安全但是是幂等的。幂等的核心含义在于对同一个请求执行一次,与执行多次,其“预期的服务器效果”相同,不是说每次 HTTP Response 必须完全一样。
第一次可能:
204 No Content第二次可能:
404 Not Found但它依然可以是幂等的,因为:
服务器资源最终状态 第一次删除 → 不存在 多次删除 → 仍然不存在RFC 7231 明确指出,幂等性针对的是请求所要求的“预期效果”,响应本身可以不同。同时,但是 Safe ≠ 完全没有任何副作用,
GET /article/123,服务器收到后可能:读取文章
↓
记录访问日志
↓
统计访问次数
↓
写日志数据库所以服务器实际上发生了变化,但它仍然是 Safe,因为这些不是客户端通过 GET 请求所要求的业务状态变化。因此判断 Safe 时,关注的是:请求的“定义语义”是不是要求修改服务器资源,而不是“服务器内部是不是绝对什么东西都没改变。”
安全性和幂等性规范带来的好处:
—— 遵守安全与幂等约定,才能让 HTTP 缓存(浏览器缓存、Edge/CDN 节点)、反向代理(Nginx 重试机制)发挥最大效能。如果用 GET 去做写操作,预加载引擎或搜索引擎爬虫就可能误删数据。
—— 网络故障下的容错重试策略。
在分布式系统中,如果超时未收到响应:
—— 对于 GET / PUT / DELETE(幂等):客户端或网关可以安全地自动发起重试。
—— 对于 POST(非幂等):不能盲目重试,必须依赖业务层引入防重 Token 或幂等键(Idempotency Key)。
—— API 接口的契约可读性。遵循标准的语义,可以让 API 见名知意,极大地降低前后端协作与外部对接的沟通成本。
三. 10种HTTP方法的用法和特点
1. GET:获取资源
  // 给我用户 123 的数据
 GET /users/123

  // 服务器返回
 {
  "id": 123,
  "name": "Andrew"
}
// 带查询条件获取列表
GET /users?page=2&keyword=tomGET 的特点是: GET = 读取,理论上不应该产生修改操作。
2. POST:提交数据,创建资源。
这个用的最多,也最容易理解。
大部分人容易陷入误区(如“GET 参数在 URL,POST 在 Body”或“POST 比 GET 更安全”),但这些只是浏览器实现或应用层的表现,并非 HTTP 规范的本质。
GET 的底层逻辑:
—— 只读契约:客户端表明“我只是想拿数据,不会改变任何东西”。
—— 架构收益:因为安全且幂等,浏览器、CDN、代理服务器可以放心地缓存 GET 请求。这是整个互联网能够承受巨量流量的基础。POST 的底层逻辑:
—— 非幂等与状态变更:客户端表明“我要提交数据,请服务器按照自己的逻辑去处理”。
——架构收益:不强制要求针对特定 URI,处理逻辑高度灵活。由于非幂等,浏览器在刷新的 POST 页面时会弹窗警告(防止重复提交/重复扣款)。
3. PUT:完整更新
假设原来的用户:
{
   "id": 123,
   "name": "Andrew",
   "age": 30,
   "email": "a@test.com"
}发送:
 PUT /users/123

 {
   "name": "Tom",
   "age": 25,
   "email": "tom@test.com"
}语义是:
用新的完整数据替换原来的资源。
旧用户
↓
完全替换
↓
新用户
4. PATCH:局部更新
例如,只改用户名:
PATCH /users/123
 {
   "name": "Tom"
}意思:
只修改
name,其他字段保持不变。PUT → 全量更新
PATCH → 部分更新
5. DELETE:删除
//删除用户 123
DELETE /users/123

服务器:

 204 No Content

或者:

 {
   "code": 200,
   "message": "Deleted successfully"
}6. HEAD 方法的本质就是:“不要主体(Body)的 GET 请求”。
客户端向服务器发送 HEAD 请求时,服务器返回的响应头(Headers)与 GET 请求完全一致,但绝对不能包含任何响应体(Body)。
HEAD 方法的核心价值在于零带宽成本地获取资源的元数据(Metadata)。在真实工程中,它有几个典型应用场景:
① 预先获取大文件信息
HEAD /file.zip可以先判断:文件存在吗? 多大? 什么类型? 有没有更新?
在下载几 GB 的大文件(如系统镜像、游戏包)之前,下载工具会先发一个 HEAD 请求:
校验文件大小: 检查
Content-Length,提前判断本地磁盘空间是否足够。校验文件修改: 检查
ETag或Last-Modified,对比本地已下载的文件片段,判断服务器上的文件是否被更新过。
② 测试链接的有效性(死链检测)
搜索引擎爬虫或网站链接检查器在校验成千上万个外链时,如果用 GET 请求,会把网页的 HTML、图片全下载下来,极度浪费流量和 CPU。使用 HEAD 请求,只需几百字节的 Header 就能确认目标页面是 200、404 还是 301/302 重定向。
③ 检查服务器对断点续传(Range Request)的支持
客户端想并发分多段下载一个文件前,会先发 HEAD 请求查看响应头中是否包含:
Accept-Ranges: bytes如果包含,说明服务器支持分段读取,客户端才可以放心开多线程并行下载。
④ 高频轻量级健康检查(Health Check)
负载均衡器(如 Nginx、L4/L7 网关)或 Kubernetes Kubelet 需要每几秒钟探测一次后端服务是否活着。如果探测使用 GET,后端会不断渲染页面或查询数据库并返回响应体,造成无意义的性能损耗;而 HEAD 请求极轻,能将健康探测对业务系统的干扰降到最低。
7.OPTIONS
OPTIONS /users意思是:你这个资源支持什么操作?
服务器可能返回:
Allow: GET, POST, OPTIONS它还有一个非常重要的用途:
CORS 预检请求
例如:https://mosang.net,调用 API:https://api.xiaobage.com/,浏览器可能先自动发送:
OPTIONS /users询问服务器:“这个网站是否允许我跨域访问?”
所以后端日志里有时会看到:
OPTIONS /api/users这通常不是用户直接操作,而是浏览器自动发出的。
8. CONNECT
这个一般普通 Web 开发很少主动使用。
例如访问:HTTPS 网站,代理服务器需要建立隧道:
 浏览器
    │
 CONNECT
    ↓
 代理服务器
    │
 建立隧道
    ↓
 目标服务器
通常与:HTTPS Proxy 相关。
9. TRACE:会让服务器把请求“反射”回来。
例如:
TRACE /users服务器把:请求方法、请求头等信息返回。主要用于诊断、调试 HTTP 链路,但因为安全原因,很多服务器直接禁用了它。
10. QUERY
GET 只能把参数放在 URL(Query String)里。但现在的商业系统查询条件极度复杂(如复杂的 JSON 过滤树、长文本特征对比、大数组 ID 查询)。URL 长度是有限制的(通常浏览器/网关限制在 2KB ~ 8KB),超出就会抛出 414 URI Too Long 错误。为了解决 URL 长度限制,大家不得不改用 POST 把复杂查询条件放在 Body 里。但这一改就打破了规矩:
无法被 CDN 缓存: 默认情况下,几乎所有 CDN 和浏览器都拒绝缓存
POST请求。破坏安全性与幂等性: 监控系统和中间件会把这个查询误认为是“数据写操作”,引发误判。
为了解决这个“想用 Body 传复杂查询参数,但又想保持安全与可缓存”的僵局,IETF 提出了全新的 QUERY 方法(最早叫 SEARCH)。
QUERY 方法的官方定义是:Safe(安全的) + Idempotent(幂等的) + 支持 Request Body(有请求体)。
QUERY /products/search HTTP/1.1
Host: api.example.com
Content-Type: application/json
{
"category": "electronics",
"price_range": {"min": 100, "max": 500},
"tags": ["wireless", "gaming", "noise-canceling"],
"sort_by": "rating_desc"
}它的核心意义在于:
语义精准: 明确告诉所有中间件“我只是在查数据(安全、幂等),请不要害怕,也不会修改服务端状态”。
容量无界: 查询条件可以任意复杂、任意大,完全放在 Request Body 中,再也不用担心 URL 超长。
重新解锁缓存(关键突破): 因为QUERY明确宣告了自己是安全的,CDN 和网关可以基于URL + Request Body的 Hash 值来重新实现自动化缓存。
四. HTTP方法语义化的本质
这些方法本质是在语义化描述:
这个请求是在读取、创建、替换、修改、删除,还是在查询通信能力。
HTTP Method 的语义可以帮助:
浏览器
HTTP 客户端
代理服务器
缓存系统
开发者
这能让整个互联网生态更好衔接,例如让服务器优化缓存、让中间件(CDN/代理/网关)能够盲操作,让爬虫与搜索引擎有确切的安全边界,同时标准化语义让接口设计变成了“统一语言”:
HTTP 方法不是简单的“不同名字”,它会影响:
缓存
重试
代理
安全策略
浏览器行为
CORS
服务器路由
统一的语义大幅降低了多端协同(前端、移动端、后端、第三方开放 API)的沟通与对接成本。
在现实的工程实践中,像 Laravel(PHP 领域代表)、Spring Boot(Java 领域代表)以及 Ruby on Rails、Express/NestJS(Node.js)等主流 Web 框架,从框架设计层面,是完全且深度遵循并拥抱这种语义化 HTTP 方法。
Spring Boot (Java):
@RestController @RequestMapping("/users") public class UserController { // 严格匹配 HTTP DELETE /users/123 @DeleteMapping("/{id}") public ResponseEntity<Void> deleteUser(@PathVariable Long id) { userService.deleteById(id); return ResponseEntity.noContent().build(); // 返回 204 No Content } }Laravel (PHP):
// routes/api.php 严格匹配 HTTP DELETE /api/users/123
Route::delete('/users/{id}', [UserController::class, 'destroy']);
五. 语义化的落地执行:RESTful规范
REST 到底是什么?
REST的全称是Representational State Transfer,中文对应词是“表现层状态转移”。REST 是“理论/架构风格”(概念),而 RESTful 是“符合这种理论的具体实现/设计”(属性/修饰词)。
话说REST这个名字实在是个很差劲的表达,晦涩难懂。甚至连许多搞了多年 RESTful API 架构的人,第一次看到 Representational State Transfer 以及中文翻译“表现层状态转移”时,也是一头雾水。
这个词是HTTP/1.1 的主要架构师之一Roy Thomas Fielding,在他的博士论文中提出的,是一个学术味浓、表达追求极度严谨的词,是一个典型的“学术抽象合成词”。
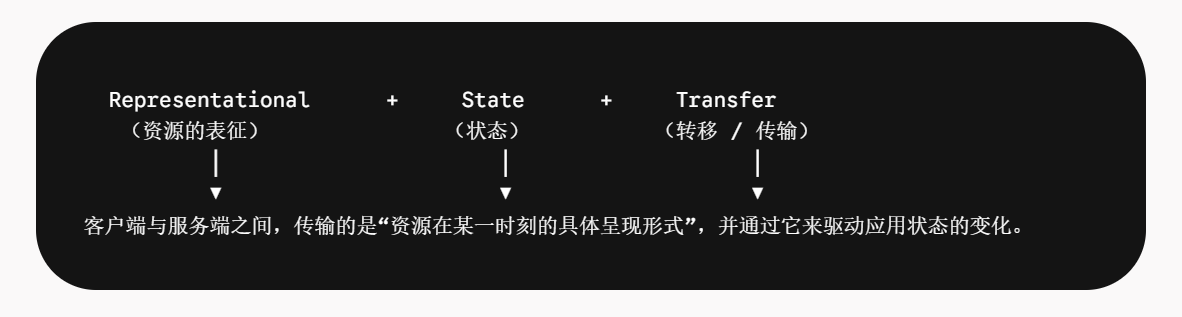
1. Representation(表征 / 表现层)
字面意思:某样东西的“呈现形式”或“代名符”。
大白话:数据格式(如 JSON、XML、HTML、图片等)。
底层逻辑:你在服务器数据库里存储的某条用户记录(比如包含各种外键、原始字节的二进制数据),并不是直接传给客户端的。服务器会把它包装成某种“表征形式”(比如一段 JSON 字符串 {"name": "張三", "age": 20})发给客户端。客户端看到的永远是资源的“表征”,而不是资源本身。
2. State(状态)
字面意思:当前所处的情况或数据。
大白话:应用/数据的当前页面或数据快照。
底层逻辑:这里包含两种状态:
资源状态(Resource State):服务器端存储的数据当前长什么样(比如订单是“已支付”还是“待发货”)。
应用状态(Application State):客户端当前处于什么流程或页面(比如你在浏览商品列表页,还是购物车结算页)。
3. Transfer(转移 / 传输)
字面意思:移动、传递。
大白话:在网络上搬运/传递。
底层逻辑:客户端和服务器通过 HTTP 协议把这种“表征”在网络上来回传递,从而让客户端从一个状态“跳转/迁移”到另一个状态。
如果抛弃那些晦涩的学术词汇,用更符合人类直觉的语言,REST 其实可以翻译为:“基于资源表征的状态切换”“通过数据快照驱动应用跳转”。
REST 最核心的思想:把一切东西看成 Resource
假设系统里面有:
用户
订单
商品
文章
文件
评论
REST 会把这些抽象成:
Resources(资源)
例如:
用户:
/users/100

订单:
/orders/12345

商品:
/products/888

文章:
/articles/50
于是 REST 的思维发生了一个非常重要的变化:
传统 API 很容易这样设计:
/getUser
/createUser
/updateUser
/deleteUser

/getOrder
/createOrder
/updateOrder
/deleteOrderREST 则倾向于:
/users/100
/orders/12345API设计成:
GET    /users/100
POST   /users
PUT    /users/100
DELETE /users/100动作由 HTTP Method 表达,资源由 URL 表达,这其实就是 REST 最核心表达,RESTful就是符合这种风格的API设计。
REST 不是协议,REST 更像一套设计 Web 系统的原则,其中对 API 设计影响最大的是:Uniform Interface(统一接口),这也是 REST 最精髓的地方之一。
HTTP方法非常广泛:远不止以上举例的10个
在文初列出的这 10 个(基础 9 个 + 新增的 QUERY)是 HTTP 核心/通用标准 中最主流的方法。但实际上,远远止于这 10 个。HTTP 协议在设计之初就具备极强的扩展性,标准规范(IANA 注册表)中记载的官方 HTTP 方法以及各种扩展协议(如 WebDAV)中的方法多达几十个。
一、 WebDAV 扩展方法(分布式创作与版本控制)
WebDAV(RFC 4918) 是 HTTP 最著名的扩展协议之一(用于网盘、网关、在线文档协作、日历同步等)。它新增了一整套处理文件和目录的管理方法:
| 方法 | 主要作用 |
| PROPFIND | 获取资源的属性(如文件大小、创建时间、修改作者等) |
| PROPPATCH | 修改或删除资源的属性 |
| MKCOL | 创建集合/文件夹(Make Collection) |
| COPY | 复制文件或目录到指定位置 |
| MOVE | 移动或重命名文件/目录 |
| LOCK | 锁定资源,防止多人协同编辑时发生冲突 |
| UNLOCK | 解除资源的锁定状态 |
二、 CalDAV / CardDAV 扩展方法(日历与通讯录同步)
苹果 iOS、Google Calendar 和 Outlook 在同步日历与联系人时,底层走的也是 HTTP 扩展方法(基于 RFC 4791):
| 方法 | 主要作用 |
| REPORT | 用于根据特定条件(如时间段)检索日历事件或通讯录条目 |
三、 Delta Encoding 扩展(增量传输)
用于优化网络传输效率的 HTTP 扩展规范(RFC 3229):
| 方法 | 主要作用 |
| A-IM | (Accept-Instance-Manipulation) 用于请求资源的增量差异(只获取改动的部分,无需下载整个新文件) |
四、 安全与授权领域方法
| 方法 | 主要作用 |
| ACL | 用于修改资源的访问控制列表(Access Control List),定义谁有权限读写该资源 |
我们可以自定义HTTP方法
从 HTTP 协议规范的角度来看,HTTP 方法本质上就是一个 ASCII 字符串(区分大小写,由英文字母构成)。
只要客户端和服务端协商一致,你完全可以自己发明一个全新的方法,比如定义一个 PURGE 请求用来清空 CDN 缓存:
PURGE /static/main.js HTTP/1.1
Host: cdn.example.com
例如:著名的 HTTP 缓存代理服务 Varnish 和 Nginx (带有 ngx_cache_purge 模块),在现实工程中就大量使用自制的 PURGE 方法来精准清除缓存。
我们在前端也可以使用自定义方法来与后端数据交互:
fetch('https://api.xiaobage.cc/cache', {
  method: 'PURGE', // 自定义 HTTP 方法
  headers: {
    'Content-Type': 'application/json'
  }
})
.then(response => response.json())
.then(data => console.log(data));当你运行这段代码时,浏览器会毫无保留地将这个请求封装好并发送出去。在浏览器的 F12 开发者工具(Network 面板)以及 WireShark 抓包中,可以清楚地看到请求行第一行就是:
PURGE /cache HTTP/1.1 Host: api.example.com虽然浏览器会帮你发出去,但会触发以下两个重要机制:
1. 跨域时,必然触发 OPTIONS 预检请求(CORS)。因为自定义方法(如 PURGE)不属于 CORS 规范中的“简单方法”(GET、POST、HEAD),所以如果发起跨域请求,浏览器会在发送 PURGE 之前,强制先发一个 OPTIONS 预检请求。
2. HTML 原生标签不支持。 无法通过原生 HTML 元素(如 <form method="PURGE">)来发送自定义方法。如果强行写入,浏览器解析 HTML 时会自动将其退化/降级为默认的 GET 请求。
另外,Nginx / 代理服务器默认情况下,Nginx 等 Web 服务器能够接收并转发任何标准的或自定义的 HTTP 方法。但如果在配置中写了严格的匹配规则(例如 if ($request_method !~ ^(GET|POST)$ ) { return 405; }),自定义方法就会被直接拦截并返回 405 Method Not Allowed。WAF / 防火墙 / CDN为了防范未知攻击,会默认将非标准 HTTP 方法直接阻断。
现实情况:绝对的“RESTful”很少,几乎绝迹
例1.
假设我们在开发一个电商系统,要获取订单详情并完成支付。
GET /api/v1/orders/8888 HTTP/1.1
Host: api.example.com服务器响应:
{
"order_id": 8888,
"status": "UNPAID",
"total_amount": 199.00,
"items": ["MacBook Pro Cover"]
}下一步支付: 前端开发者必须查阅 API 文档,得知“支付订单要发 POST 到 /api/v1/orders/8888/pay”,然后在代码里写死这个逻辑:
// 前端代码硬编码了 URI 路径和业务判断逻辑
if (order.status === "UNPAID") {
axios.post(`/api/v1/orders/${order.order_id}/pay`);
}这显然支付不符合RESTful标准。
在 Roy Fielding 理想的绝对 RESTful 系统中,客户端不需要预先看文档,也不需要硬编码任何业务 URL。API 像浏览器刷网页一样,通过响应中返回的链接(Links)驱动客户端做出下一步动作。
同样是获取订单详情:
请求:
GET /api/v1/orders/8888 HTTP/1.1
Host: api.example.com
响应:
{
  "order_id": 8888,
  "status": "UNPAID",
  "total_amount": 199.00,
  "_links": {
    "self": { "href": "/api/v1/orders/8888", "method": "GET" },
    "cancel": { "href": "/api/v1/orders/8888/cancel", "method": "DELETE" },
    "pay": {
      "href": "/api/v1/payments",
      "method": "POST",
      "title": "Pay this order",
      "schema": { "payment_method": "credit_card|alipay" }
    }
  }
}
下一步支付: 前端完全不关心支付的 URL 长什么样。它只需要寻找响应里的 _links.pay 属性,直接发起调用:
// 前端不需要拼接 URL,完全由响应中的超链接动态驱动
if (response._links.pay) {
  axios({
    method: response._links.pay.method,
    url: response._links.pay.href,
    data: { payment_method: "alipay" }
  });
}
如果订单状态变成了“已支付”,后端返回的 JSON 中就会自动抹去 pay 和 cancel 链接,替换为 ship(发货)或 refund(退款)链接。
这种绝对的RESTful(Level 3:HATEOAS),看起来非常优雅(后端改变 URL 不会破坏前端,解耦到了极致),但在实际开发中,它存在不可忽视的硬伤:
客户端往往是专用 UI:网页和 APP 的界面按钮是固定的,即使后端动态给出了一个 refund 链接,前端 UI 如果没有提前画好“退款”按钮和交互弹窗,依然无法处理。
前后端开发成本飙升:后端需要为每个 API 动态计算和拼接庞大的 _links 元数据,数据传输体积变大;前端逻辑也变得高度抽象,调试极其痛苦。
前后端协作模式变化:现实中前后端通常由不同团队并行开发,双方通过 Swagger / OpenAPI 等静态文档来约定 API 格式,而不是靠运行时的动态发现。
因此,GitHub API 或 PayPal API 等少数企业曾尝试引入 HAL/HATEOAS 规范,但在全行业范围内,99% 的 API 都选择停留在了“用 URI 表示资源 + 用 HTTP 动词表示操作 + 返回 JSON 数据”的 Level 2 阶段。这就是为什么绝对的 RESTful 极其罕见的原因。
例2 最典型的:一个动作根本不是 CRUD
例如电商:
POST /orders/123/cancel这其实就不是严格意义上的:
DELETE /orders/123因为:
取消订单 ≠ 删除订单
订单仍然存在,只是状态从:
PENDING
   ↓
CANCELLED所以你可能会设计:
POST /orders/123/cancel甚至:
POST /orders/123/pay
POST /orders/123/ship
POST /orders/123/confirm
POST /orders/123/refund这些明显带有 RPC(Remote Procedure Call) 的味道:
“请服务器执行这个动作。”
而不是纯粹:
“我正在操作一个资源。”
这在现实中非常普遍。
例3 “执行任务”特别难 REST 化
例如 PDF 服务:
POST /pdf/generate或者:
POST /documents/123/render服务器可能需要:
读取模板
↓
加载字体
↓
生成 PDF
↓
合成图片
↓
上传 OSS
↓
返回文件这实际上是:
Command / Job
而不是简单的 Resource CRUD。
真正的大型 API 往往长这样:
                API
                 │
        ┌─────────┴─────────┐
        │                   │
   Resource API        Command API
        │                   │
    RESTful             RPC-like
        │                   │
   /users/123          /login
   /orders/123         /orders/123/pay
   /products/123       /orders/123/cancel
   /comments/123       /products/search
                       /reports/export
/pdf/generate这才是最常见的。
我们需要知道的是,REST 不是一种技术,而是一种“用标准格式(如 JSON/HTML)在客户端和服务器之间传递资源快照,从而驱动业务流程演进”的设计风格。